Google libera TorchTPU para ejecutar PyTorch de forma nativa en sus TPU, en colaboración con Meta
El nuevo backend permite llevar modelos de PyTorch a los chips de Google cambiando el dispositivo de destino, con modo eager y torch.compile. Llega con integraciones para vLLM, SGLang, TorchTitan, Ray y Hugging Face.
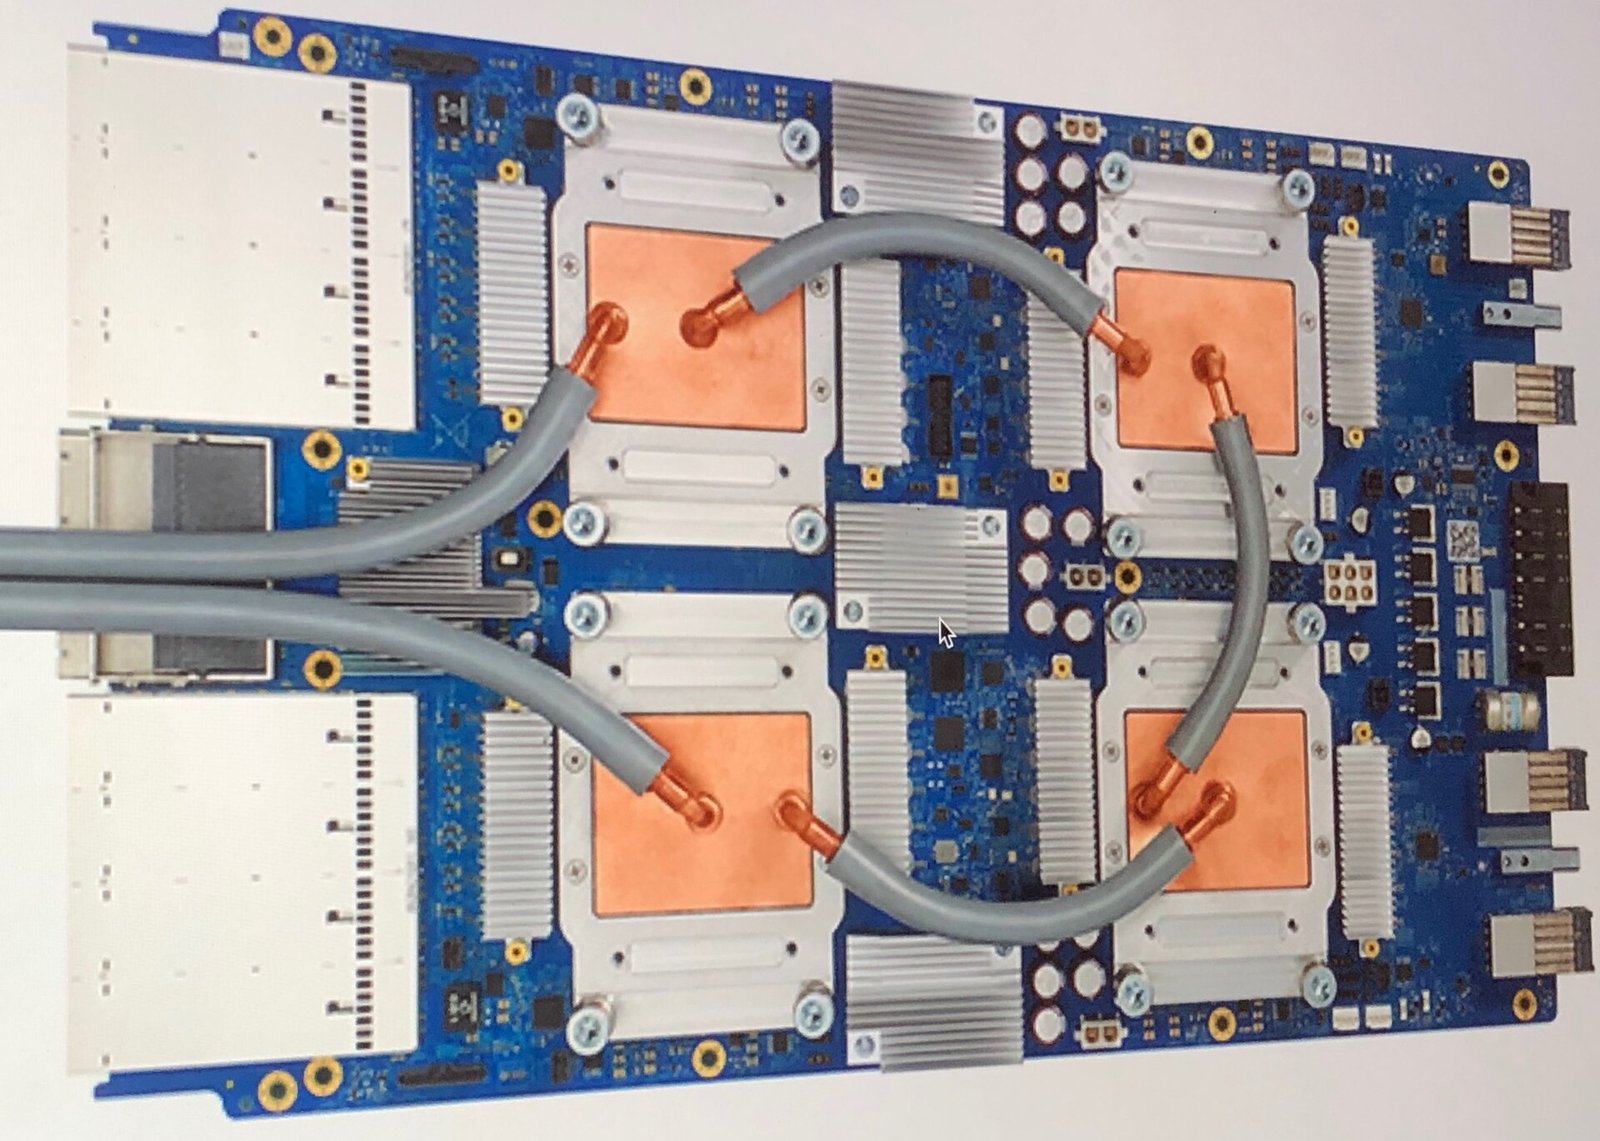
Las unidades de procesamiento tensorial (TPU) de Google llevan una década entrenando y sirviendo modelos de IA, pero siempre han tenido una desventaja frente a las GPU de NVIDIA: su ecosistema natural eran TensorFlow y, más tarde, JAX, mientras que la mayor parte de la investigación y la industria trabaja en PyTorch. El puente existente, PyTorch/XLA, presentado en 2020, exigía modificar el código para delimitar regiones compilables, sufría largos tiempos de compilación y no admitía bien el modo de ejecución inmediata, conocido como eager. En la PyTorch Conference 2026, celebrada el 20 de octubre, Google anunció la publicación como código abierto de TorchTPU, un backend nativo de PyTorch para sus TPU desarrollado desde mediados de 2025 junto con el equipo de PyTorch de Meta.
La propuesta es que un modelo escrito para GPU pueda ejecutarse en TPU cambiando el dispositivo de destino, de “cuda” a “tpu”, sin dependencias de JAX en tiempo de ejecución. El proyecto prioriza el modo eager, en el que las operaciones se ejecutan una a una como en una GPU, y añade un modo intermedio llamado DeferAndFuse que agrupa varias operaciones antes de compilarlas y que, según el equipo, puede ser un 50 % o más rápido que el eager estricto mientras reduce el uso de memoria. Para producción, se integra con torch.compile a través de Dynamo, el compilador estándar de PyTorch, y genera un único programa StableHLO para el compilador XLA. Los equipos distribuidos se apoyan en las primitivas habituales de PyTorch, como FSDP o DTensor, con las operaciones colectivas implementadas en la capa de grupos de procesos.
Google y Meta reconocen las diferencias de hardware que todavía condicionan el rendimiento. El simple cambio de dispositivo hace que el modelo funcione, pero no garantiza aprovechar el chip, porque las formas de los tensores y las operaciones suelen estar pensadas para GPU. Las TPU necesitan además conocer las dimensiones de los tensores al compilar, por lo que el equipo trabaja en un mecanismo de dinamismo acotado para evitar recompilaciones, y cada TPU solo puede ser usada por un proceso a la vez, lo que por ahora impide ciertos esquemas de aprendizaje por refuerzo. Para núcleos personalizados, TorchTPU admite Pallas y la biblioteca Tokamax, y de forma experimental el lenguaje Helion.
Según el blog técnico del proyecto, TorchTPU ejecuta sin errores el 98 % de un conjunto de 4.917 modelos populares de Hugging Face y reproduce los resultados numéricos de GPU en el 97 % de 657 arquitecturas representativas. En entrenamiento a gran escala, el equipo afirma haber escalado un modelo Qwen3 de 235.000 millones de parámetros hasta 8.192 chips TPU v7 con una utilización de cómputo prácticamente constante, y haber medido en 64 chips un rendimiento cercano al de JAX con MaxText. Son cifras de los propios desarrolladores. El anuncio llega con integraciones para vLLM, SGLang, TorchTitan, Ray y TorchRec, soporte en Transformers v5 de Hugging Face, la versión 1.0 de llm-d para inferencia distribuida en Kubernetes y la incorporación de LiteRT, el motor de inferencia en dispositivos de Google, al ecosistema de PyTorch.
Meta explicó por boca de Jana van Greunen, directora de ingeniería de PyTorch, que no puede depender de una sola arquitectura de hardware y que TorchTPU le permite desplegar cargas de PyTorch en TPU de Google. Como análisis, ese es el punto de fondo: el software, más que el silicio, ha sido la principal barrera para competir con NVIDIA, cuyo ecosistema CUDA retiene a los desarrolladores. Si TorchTPU cumple su promesa de portabilidad, reducirá el costo de cambiar de proveedor de cómputo, aunque el rendimiento máximo seguirá exigiendo optimizaciones específicas. El equipo indicó que su hoja de ruta de los próximos 6 a 12 meses se centra en consolidar el modo eager, el dinamismo acotado y el soporte de formatos FP8 y FP4.
Fuentes
- PyTorch Blog: Introducing TorchTPUpytorch.org
- Google Cloud Blog: TorchTPU is now open source: Run native PyTorch on TPUscloud.google.com
- TorchTPU: documentacióntorchtpu.readthedocs.io