Microsoft presenta Maia 300, su chip de inferencia propio, y lo convertirá en su sistema principal desde 2027
La tercera generación de aceleradores Azure Maia promete 40 % más tokens por megavatio que los sistemas basados en GPU líderes. Microsoft llevará la familia Maia a despliegues de varios gigavatios a partir de 2027.
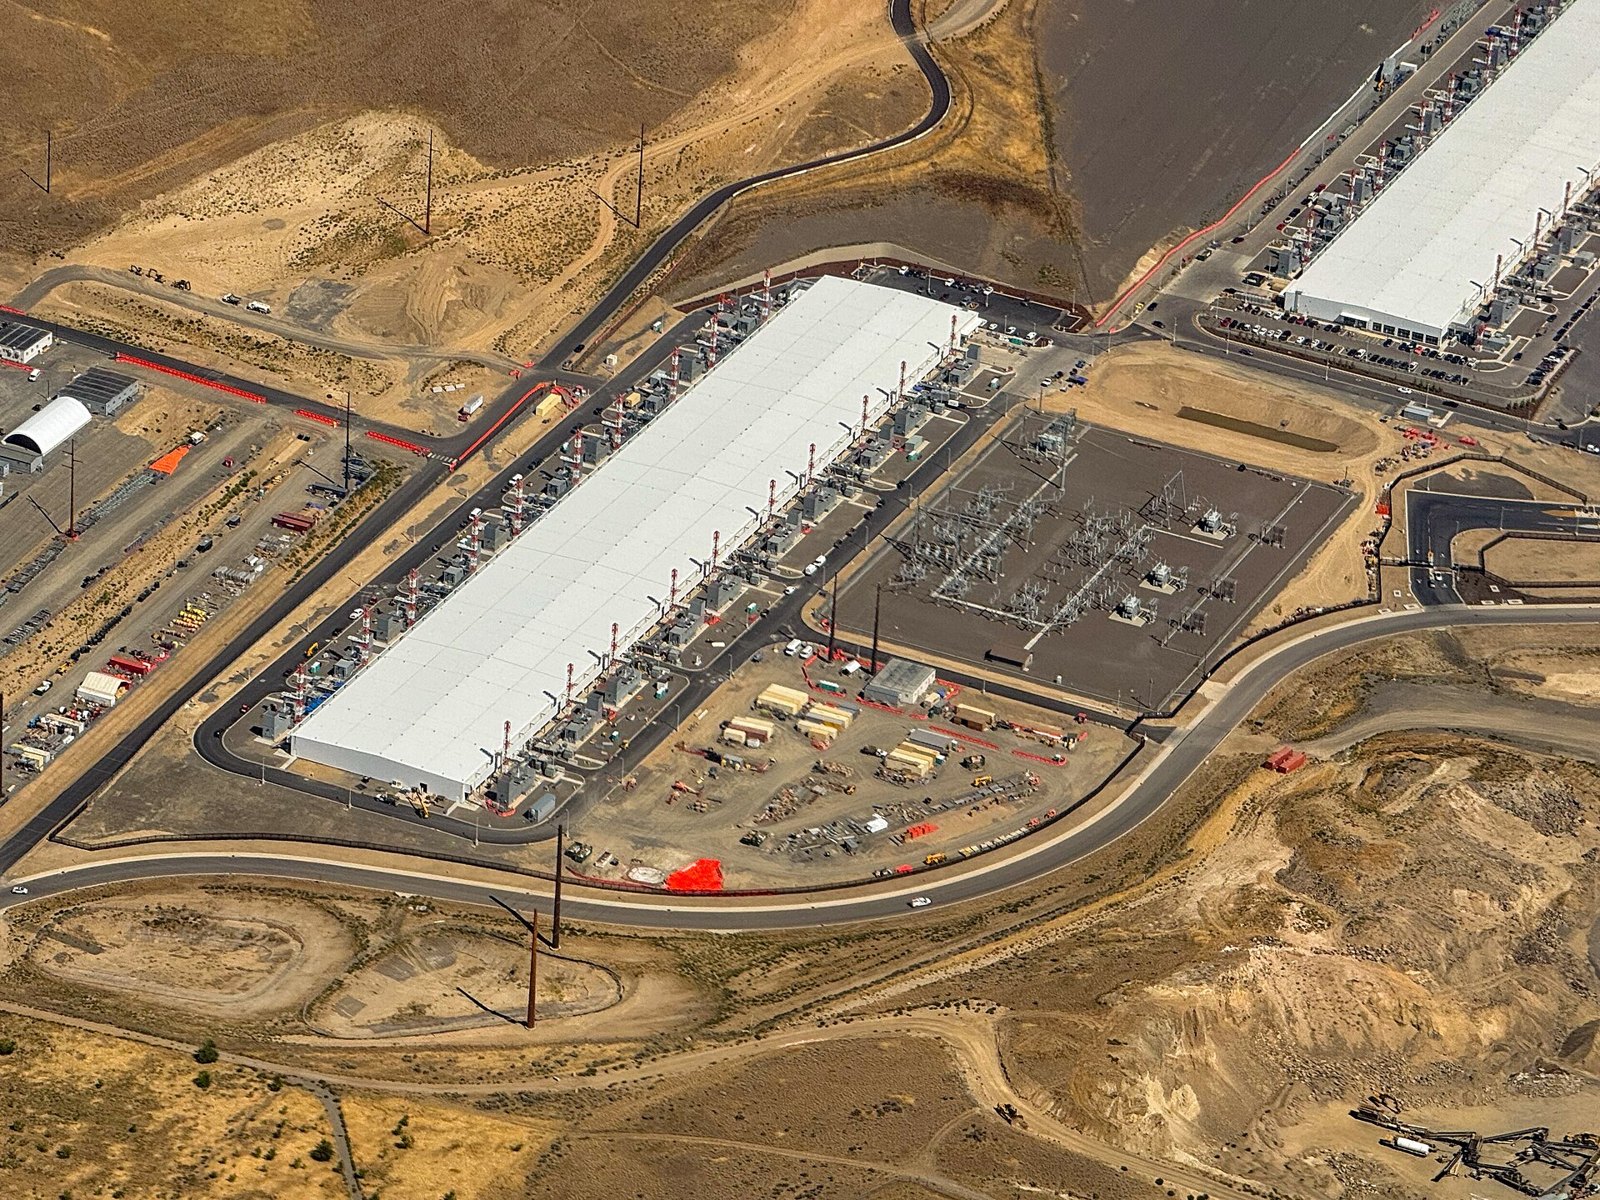
Microsoft anunció el 12 de octubre Maia 300, la tercera generación de su programa de aceleradores de IA Azure Maia, y la decisión de escalar esa familia a despliegues de varios gigavatios a partir de 2027. Con ese paso, Maia se convertirá en el sistema principal de inferencia para los productos y servicios de la compañía. Satya Nadella, director ejecutivo de Microsoft, lo describió en X como su mayor apuesta hasta ahora por el silicio propio.
Según Microsoft, Maia 300 está diseñado desde el principio para la inferencia, con foco en tareas de contexto largo, conversaciones sensibles a la latencia y agentes que trabajan en varios pasos. La empresa espera que entregue un 40 % más de tokens por megavatio que los sistemas basados en GPU líderes y, en un rack completo de 96 aceleradores, hasta siete veces el rendimiento en tokens de Maia 200. Son estimaciones del fabricante. Maia 300 empezará a desplegarse en producción en 2027.
En lo técnico, cada acelerador usa ocho pilas de memoria HBM4 con 18 TB/s de ancho de banda máximo dentro de un consumo térmico de diseño de 950 vatios. La arquitectura se divide en varios chiplets que separan cómputo, controladores de memoria y entrada/salida, y los chiplets de cómputo se fabrican con el proceso N2P de TSMC. El chip admite formatos de baja precisión como una versión mejorada de MXFP4 para reducir el uso de memoria. Cada rack reúne 96 aceleradores en una envolvente de 167 kilovatios, con 27,6 TB de memoria HBM y 1,7 PB/s de ancho de banda agregado, y la interconexión entre racks se apoya en redes Ethernet con un protocolo de transporte propio.
La generación anterior, Maia 200, ya atiende cargas de producción como Microsoft Copilot y se está desplegando en Estados Unidos, Europa y Australia; GitHub Copilot y Microsoft Foundry la usarán antes de fin de año, según la compañía. Microsoft afirma que Maia 200 ejecuta modelos de OpenAI, sus propios modelos MAI y familias de código abierto, y que ofrece hasta 1,7 veces más tokens por vatio que la infraestructura de GPU líder en funciones de IA de Teams y Copilot. La empresa adelantó que dará más detalles en Microsoft Ignite 2026, el próximo mes en San Francisco.